Workflow d'IA agentique : l'architecture derrière le Knowledge Builder

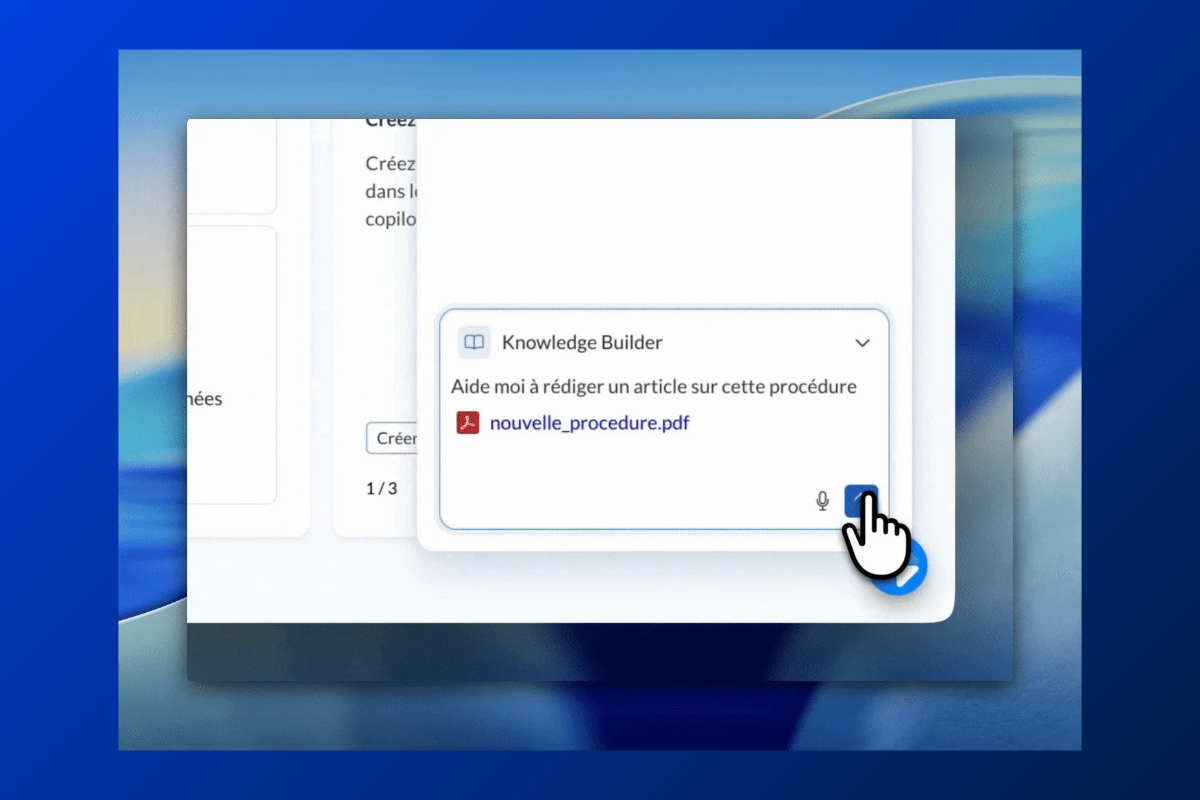
Créer du contenu pour une base de connaissance prend du temps. Beaucoup de temps. C'est le principal frein des équipes qui documentent leurs processus, et l'IA générative promettait de le lever : décrivez ce que vous voulez, elle rédige l'article.
Notre agent IA dédié à la création d'articles et de diagnostics, le Knowledge Builder, est parti de cette promesse.
Dans cet article, nous racontons ce que nous avons exploré, ce que nous avons écarté, et l'architecture que nous avons construite pour plus d’efficacité.
Le retour qui a tout déclenché
Le déploiement de notre outil Knowledge Builder est parti de la même promesse que tout le marché à ce moment-là : décrivez ce que vous voulez documenter, et l'IA se charge de rédiger.
Techniquement, ça marchait : le contenu était produit rapidement et se lisait bien.
Et pourtant, les retours de nos utilisateurs allaient tous dans la même direction :
- « Le contenu est trop générique, pas assez précis. »
- « La structure et le format ne sont jamais vraiment homogènes. »
- « Je vais plus vite à le faire moi-même, je dois tout réécrire. »
- « Je n'ai pas confiance dans le résultat, donc je ne l'utilise pas. »
Ce que nos utilisateurs nous décrivaient n'était pas un problème de qualité rédactionnelle. C'était un problème de reprise. Le contenu sortait complet, mais il fallait le relire entièrement pour savoir ce qui fonctionnait ou non. La structure ne correspondait pas toujours à leur modèle d'article. Certains passages s'appuyaient sur des généralités plutôt que sur leurs procédures... Et surtout : impossible de savoir où ça avait dérapé dans le processus.
Le geste réel d’un utilisateur n'était donc pas de générer puis publier, mais plutôt de générer, relire ligne à ligne, reprompter, regénérer, recommencer. Le temps que l'IA faisait gagner à l'écriture, elle le reprenait à la relecture.
« Il y avait peu d'utilisation de l’outil parce que c'était une fonctionnalité à sens unique : l'utilisateur prompte, l'agent crée le contenu. Or personne n'arrive à produire le contenu parfait du premier coup, parce qu'un agent IA sans contexte est très mauvais pour créer un contenu pertinent. »
Théo Rosen, Product Manager IA, Mayday
Nous aurions pu traiter ce retour comme un problème de prompt system à affiner. Nous avons choisi de le traiter comme un problème d'architecture.
Pourquoi le one-shot prompting a ses limites (et pourquoi changer de modèle n'y change rien)
Le réflexe naturel quand un résultat n'est pas à la hauteur, c'est de vouloir un modèle plus puissant. Et c'est une hypothèse légitime : un modèle plus récent écrit mieux, raisonne sur des contextes plus longs, se trompe moins sur les faits qu'il connaît. Le contenu produit paraît meilleur, mais n’est pas pour autant plus exploitable. Parce qu'un modèle plus puissant améliore la qualité du texte, pas la façon dont il est produit : il fait toujours tout en une fois et il reste toujours impossible de savoir à quel moment il a extrapolé.
La raison est structurelle. Quand vous demandez à un modèle unique de produire un article complet en une seule fois, vous lui demandez en réalité d'exécuter quatre missions cognitives distinctes en même temps : identifier les sources fiables, construire un plan, rédiger, puis vérifier sa propre production.
Ces quatre missions ont des objectifs contradictoires, et c'est sur les sources que la contradiction est la plus nette :
- Chercher, ce n'est pas ouvrir un document. C'est déterminer où regarder : dans votre base, vos documents connectés, lire ce qui s'y trouve réellement, et surtout arbitrer : cette procédure est-elle à jour ? Cet article et cette note interne se contredisent, lequel fait foi ? Cette information existe-t-elle chez vous, ou seulement dans ce que le modèle a appris ailleurs, sur internet, chez d'autres entreprises, dans un contexte qui n'est pas le vôtre ? La recherche demande de la rigueur, de la traçabilité, et la capacité à conclure : « cette information n'existe pas dans vos sources. »
- Rédiger demande l'inverse : de la fluidité, de la continuité, un texte qui se tient de bout en bout.
Un modèle qui fait les deux simultanément arbitre en faveur de la continuité. Face à une source manquante, contradictoire ou obsolète, il ne s'arrête pas pour le signaler : il comble, avec ce qu'il sait par ailleurs. Le résultat est un article qui parle de votre métier en général, là où vous attendiez votre procédure en particulier.
C'est le mécanisme de l'hallucination dans un contexte de base de connaissance. Ce n'est pas un bug du modèle, c'est la conséquence logique d'une tâche mal découpée.
Et il y a une conséquence de second ordre, plus coûteuse encore pour un gestionnaire de connaissance : un résultat obtenu en une seule passe n'est évaluable que dans son ensemble. Vous ne pouvez pas valider le plan sans valider le texte. Vous ne pouvez pas dire « les sources sont bonnes mais la structure ne va pas ». Vous ne pouvez que tout accepter ou tout relancer. C'est exactement ce que nos clients vivaient au quotidien, et ce pourquoi ils n’utilisaient plus ce type de modèle.
Le rôle d’un knowledge manager
« Nous avons décortiqué le travail de création de contenu en parlant directement avec des knowledge manager. »
Théo Rosen, Product Manager IA chez Mayday
Parler à nos utilisateurs n'est pas une réaction, c'est notre quotidien. Ce que ce retour a changé, c'est la nature de la question que nous sommes allés leur poser. Nous ne cherchions plus à savoir ce qui n'allait pas dans l'outil, nous le savions. Nous voulions confronter ce que nous pensions savoir de leur métier à ce qu'ils en font réellement. Nous avons donc décortiqué le travail de création de contenu avec des knowledge managers, étape par étape.
Quatre constats sont revenus systématiquement :
- Le travail commence par de la recherche : avant d'écrire une ligne, il faut comprendre le sujet en profondeur. Un article qui duplique un contenu existant dégrade la base au lieu de l'enrichir.
- La structure se travaille par itérations : un bon article de connaissance n'est pas un bon texte. C'est un texte dans lequel un conseiller retrouve la bonne information en quelques secondes, sous pression, avec un client au téléphone. Cette trouvabilité se joue dans le plan, pas dans la rédaction.
- Il faut se placer du point de vue du lecteur : le rédacteur connaît le sujet. Le lecteur, non. Tout l'enjeu de la relecture est de retrouver les yeux de celui qui découvre.
- La terminologie doit être rigoureuse : le même geste métier nommé de trois façons différentes dans trois articles empêche la compréhension, et la recherche ne remonte plus rien.
Quatre missions, quatre objectifs distincts, exécutées les unes après les autres, jamais simultanément, et jamais sans que le plan soit validé avant la rédaction. C'est cette séquence que nous cherchions à retrouver et c'est exactement celle qu'une passe unique écrase.
L'exploration : ce que nous avons regardé, et ce que nous avons écarté
Plusieurs pistes ont été explorées avant d'arriver à la construction d’une architecture basée sur l'orchestration d’agent.
- Enchaîner les appels à la main (prompt chaining). Plutôt qu'une seule demande opérée auprès de l'IA, on en fait plusieurs à la suite, toujours dans le même ordre : d'abord chercher, puis structurer, puis rédiger. C'est simple à mettre en place, mais figé. La chaîne suit son script quoi qu'elle rencontre en chemin, et surtout elle n'a aucune conduite à tenir quand une étape échoue : elle continue.
- Mieux alimenter le modèle en sources (RAG enrichi). On améliore la recherche d'informations en amont pour que l'IA travaille à partir d’une meilleure matière. C'est nécessaire, et nous l'avons fait, mais c’est insuffisant seul : mieux nourrir un modèle qui doit toujours accomplir quatre tâches d'un coup ne change rien à la façon dont il les accomplit.
- Entraîner un modèle sur les formats de chaque client (fine-tuning). L'idée : apprendre à l'IA la structure documentaire propre à chaque organisation. C’est une solution personnalisée et adaptée à chaque spécificité client. Néanmoins, il faudrait maintenir autant de modèles que de clients, et cela ne réglerait toujours pas la question des sources.
Le point commun de ces trois approches : elles cherchent à améliorer une passe unique. Aucune ne rend le processus inspectable.
L'orchestration d'agents : une architecture peu répandue, pour de bonnes raisons
L'orchestration d'agents consiste à confier chaque mission à un agent spécialisé, et à faire piloter l'enchaînement par un agent dont le seul rôle est de coordonner les autres : quel agent intervient, dans quel ordre, ce qui se transmet d'une étape à la suivante, et ce qui se passe quand une étape échoue.
→ Le principe de l'orchestration d'agents, expliqué en détail 🤖
Mais le nombre d'agents n'est pas ce qui fait la différence.
« Le vrai saut architectural n'est pas de remplacer un gros prompt par plusieurs petits. C'est de rendre le processus de création contrôlable : chaque agent a une responsabilité claire, l'utilisateur valide la structure avant la rédaction, et une erreur peut être corrigée à l'étape où elle apparaît. C'est cette combinaison entre spécialisation des agents et contrôle humain qui transforme une démonstration d'IA générative en produit industrialisable. »
Olivier Maillot, Head of Data & IA chez Mayday
Sur le papier, c'est élégant. En production, c'est une autre affaire, et c'est précisément pour cela que peu d'acteurs l'exploitent réellement aujourd'hui. Passer d'un appel unique à une chaîne coordonnée fait apparaître une classe entière de problèmes que le one-shot prompting n'a pas :
- La propagation d'erreur. Une source mal qualifiée à l'étape 1 contamine tout le reste. Il faut des points de contrôle, pas seulement des étapes.
- La gestion d'état entre agents. Chaque agent doit recevoir exactement le contexte nécessaire, ni trop peu, ni tout l'historique.
- La latence. Chaque sollicitation d'un modèle est ce qu'on appelle un appel : une requête envoyée, un traitement, une réponse. Le one-shot prompting en fait un, une chaîne orchestrée en fait autant qu'elle compte d'étapes. Elle est donc mécaniquement plus lente. Or la rapidité est l'un des attraits premiers d'un LLM : un outil qui met plusieurs minutes à produire ce que l'utilisateur pense pouvoir écrire lui-même en dix ne sera pas utilisé, quelle que soit la qualité du résultat. L'enjeu n'est pas seulement de réduire ce temps, mais de le rendre lisible : montrer quel agent travaille, sur quoi, et ce qui a déjà été établi, plutôt qu'un écran de chargement qui ne dit rien.
- Le coût. Plusieurs sollicitations par contenu. L'architecture ne se justifie que si le temps de reprise économisé le compense largement.
- Le comportement en échec. C'est le point le plus dur. Que fait la chaîne quand un agent ne trouve rien ? Chez nous, la réponse par défaut n'est pas de continuer : c'est de le dire.
Ce que nous avons construit grâce à ce nouvel outil
Le Knowledge Builder repose aujourd'hui sur une chaîne d'agents spécialisés qui reproduit la façon dont un expert documente réellement un processus.
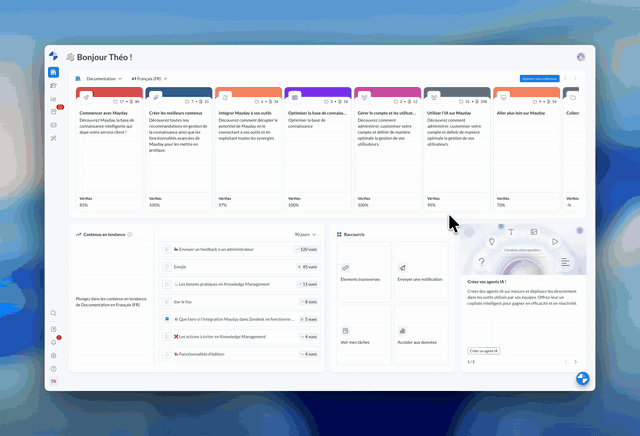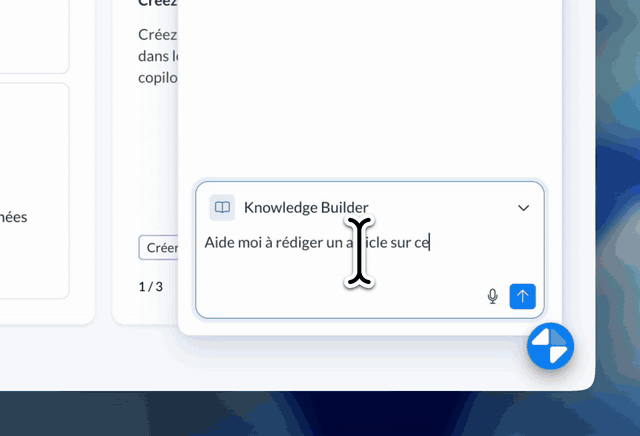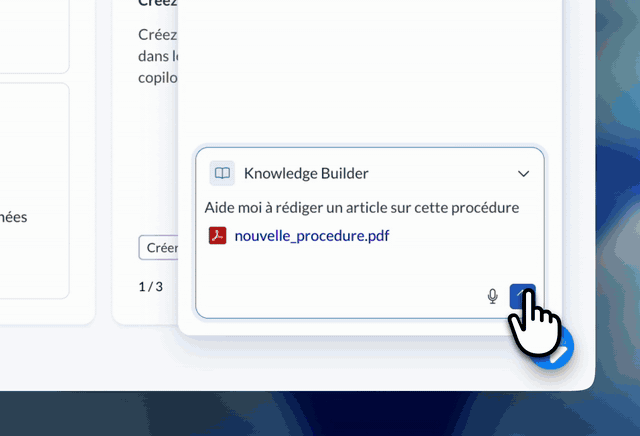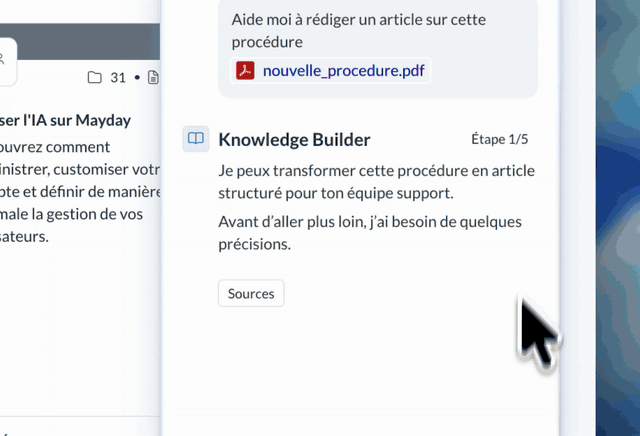
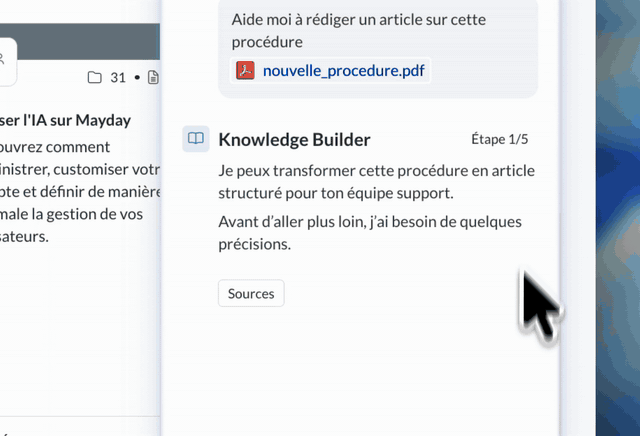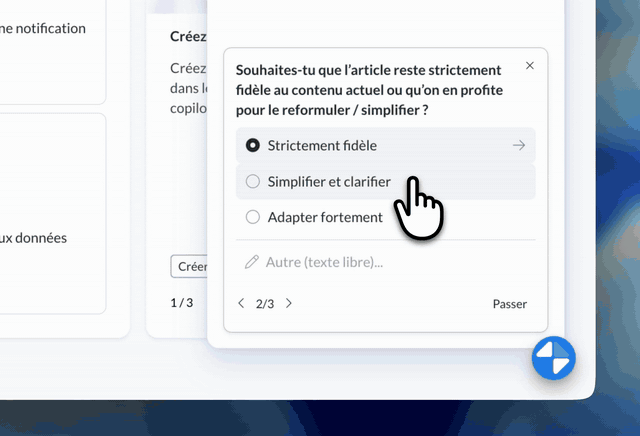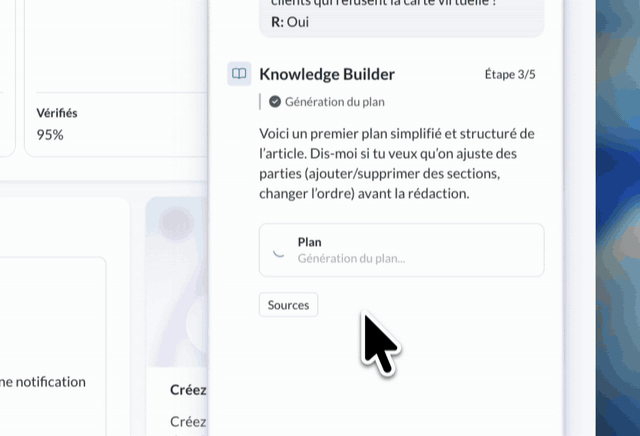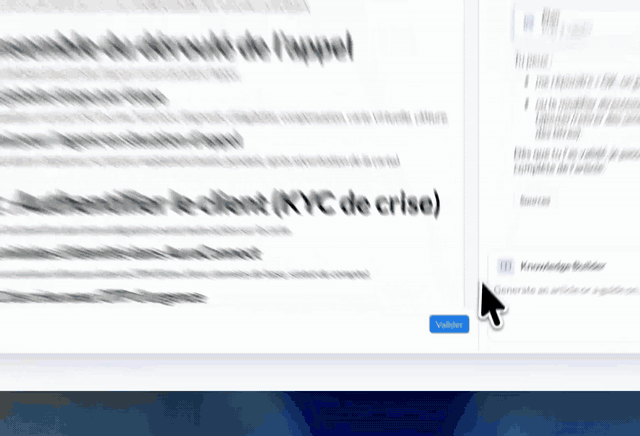
Tout commence par une question, pas par une génération. L'agent analyse votre intention et vous interroge en cas d'ambiguïté, à commencer par la plus structurante : cherchez-vous à produire un article ou un diagnostic ? Les deux ne se construisent pas de la même manière, et c'est la première chose qu'un rédacteur expérimenté détermine avant de commencer.
Ensuite :
- L'agent de sourcing identifie ce qui est réellement disponible dans votre base et dans vos documents connectés, remonte les articles connexes pertinents et mobilise vos préférences d'écriture. Sa mission n'inclut pas la rédaction, donc il n'a aucune raison de combler un manque : quand une information n'existe pas, il le signale.
- L'agent de structuration construit un plan à partir de ces sources. Il peut s'appuyer sur l'un de vos templates existants, que vous mentionnez directement dans votre demande, l'article suit alors vos sections, votre ordre, votre format, sans reformatage. Ce plan vous est soumis avant toute rédaction, et vous l'ajustez sans limite d'itérations. C'est le point de bascule de toute l'architecture : vous validez la structure quand la corriger coûte trente secondes, pas quand il faut réécrire trois mille mots.
- L'agent de rédaction écrit à partir du plan validé et des sources qualifiées, dans le format attendu.
- L'agent de relecture repasse sur la production et remonte ce qui mérite votre attention : écarts par rapport au plan validé, affirmations non adossées à une source, points à arbitrer.
L'orchestrateur pilote l'ensemble : il décide de la séquence, transmet le contexte utile à chaque étape, et gère les cas d'échec.
Le point à retenir n'est pas le nombre d'agents. C'est que vous n'intervenez plus au même moment. Dans une architecture one-shot, le contrôle humain arrive à la fin, quand tout est écrit et que tout est à vérifier. Ici, il arrive à l'étape où votre expertise a le plus de valeur : la validation du plan, puis à la décision de publier.
« On change de paradigme : l'utilisateur itère avec l'agent sur toutes les phases de création du contenu, sur la recherche de contexte, sur la structure du contenu, et sur le respect des standards de qualité. »
Théo Rosen, Product Manager IA chez Mayday
Le cas des diagnostics : là où la validation du plan compte le plus
La même chaîne de valeur produit vos diagnostics, ces arbres de décision qui guident un conseiller pas à pas. Et c'est sur ce format que l'architecture montre le mieux sa valeur.
Un article mal structuré se corrige à la relecture : vous déplacez une section, vous reformulez une transition. Un arbre de décision mal structuré, non. Si la première question n'est pas la bonne, ou si une branche manque, ce n'est pas une correction, c'est une refonte. La logique du parcours conditionne tout ce qui vient après.
C'est exactement ce qu'une génération en une passe rend impossible à contrôler, et ce que la validation du plan avant rédaction résout. Vous arbitrez la logique du diagnostic : les questions, les embranchements, les issues, avant qu'une seule étape ne soit rédigée. Vous visualisez ensuite la structure complète dans Mayflow, et vous continuez à itérer avec l'agent jusqu'à ce qu'elle corresponde à votre réalité métier.
Le résultat : un article, une conversation
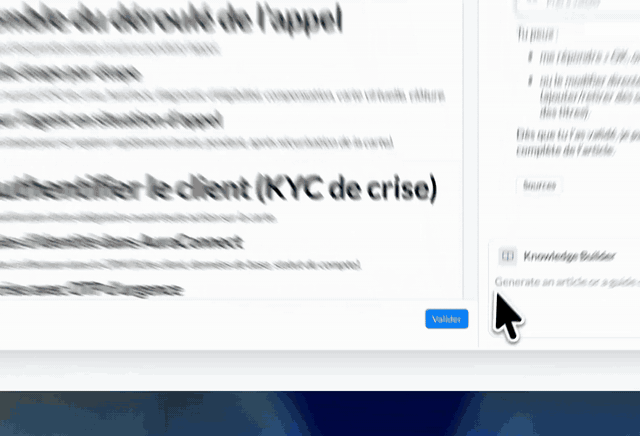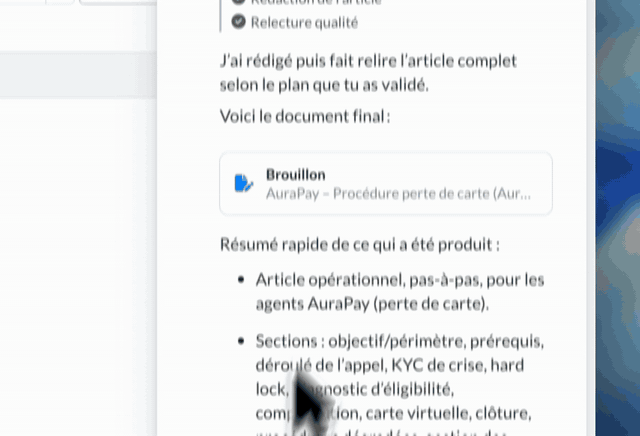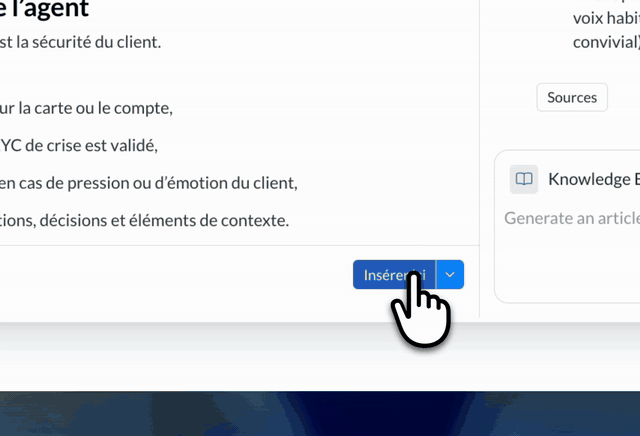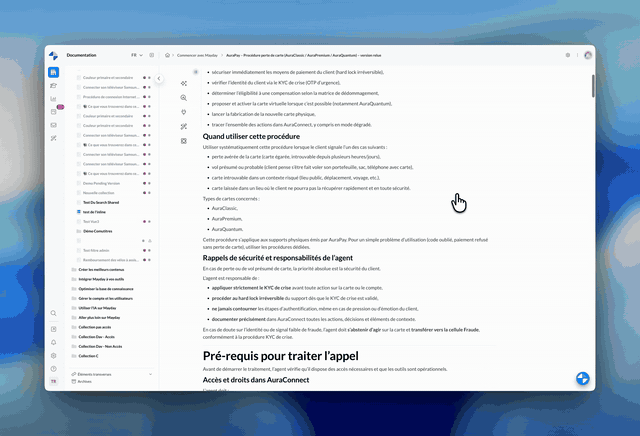
Le test que nous nous étions fixé était simple, et volontairement exigeant : produire un contenu de connaissance publiable en une seule conversation avec l'agent. Pas d'aller-retour de reprompting. Structure, contenu et format respectés dès la première production.
C'est ce que fait le Knowledge Builder aujourd'hui.
« Les utilisateurs mettent moins de temps à rédiger un contenu qui respecte leurs standards de qualité, tout en s'assurant d'optimiser la trouvabilité des réponses et la qualité de la base de connaissance. »
Théo Rosen, Product Manager IA chez Mayday
Le gain ne s'arrête d'ailleurs pas au temps de rédaction. Un contenu sourcé sur votre base, structuré selon vos standards et cohérent dans sa terminologie est un contenu que votre moteur de recherche, vos agents IA et vos conseillers exploitent mieux. La qualité de la base conditionne la qualité de tout ce qui s'y branche.
Ce que ce constat dit de notre façon de construire
Nous n'avons pas choisi l'orchestration d'agents parce que c'était la solution la plus évidente à la problématique de nos clients. Nous l'avons choisie parce que nos clients nous ont décrit précisément un problème que le one-shot prompting ne pouvait pas résoudre.
C'est aussi, plus simplement, la façon dont nous travaillons : prendre en compte les retours de nos utilisateurs, aller chercher les approches qui répondent vraiment au problème, et les mettre en production.
Envie de voir le Knowledge Builder en action ? → Réservez une démo !